★ 利用
RNN预测飞机月流量(序列数据)
具有时序性的数据,即前面的数据对后面的数据有影响,所以LSTM的记忆性能够适用于这种场景
前提:GPU版PyTorch已安装
查看方法:
import torch
print(torch.__version__) # 查看Pytorch版本
# 1.7.1
print(torch.cuda.is_available()) # 验证GPU版是否可用
# True
1 数据读取
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
%matplotlib inline

import datetime

# 数据文件(.CSV文件)和脚本放在同一目录下
data_csv = pd.read_csv('./data.csv', usecols=[1])
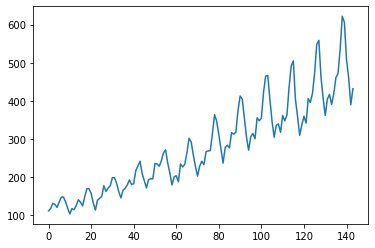
plt.plot(data_csv)  # 画出来看看
Output
2 数据预处理
进行预处理,将数据中 na 的数据去掉;
然后将数据标准化到 0 ~ 1 之间。
# 数据预处理
data_csv = data_csv.dropna()
dataset = data_csv.values
dataset = dataset.astype('float32')
max_value = np.max(dataset)
min_value = np.min(dataset)
scalar = max_value - min_value
dataset = list(map(lambda x: x / scalar, dataset))
3 数据集创建
我们想通过前面几个月的流量来预测当月的流量,比如我们希望通过前两个月的流量来预测当月的流量,我们可以将前两个月的流量当做输入,当月的流量当做输出。
同时我们需要将我们的数据集分为训练集和测试集,通过测试集的效果来测试模型的性能,这里我们简单的将前面几年的数据作为训练集,后面两年的数据作为测试集。
def create_dataset(dataset, look_back=2):
    dataX, dataY = [], []
    for i in range(len(dataset) - look_back):
        a = dataset[i:(i + look_back)]
        dataX.append(a)
        dataY.append(dataset[i + look_back])
    return np.array(dataX), np.array(dataY)
# 创建好输入输出
data_X, data_Y = create_dataset(dataset)
# 划分训练集和测试集,70% 作为训练集
train_size = int(len(data_X) * 0.7)
test_size = len(data_X) - train_size
train_X = data_X[:train_size]
train_Y = data_Y[:train_size]
test_X = data_X[train_size:]
test_Y = data_Y[train_size:]
数据改变形状
最后,我们需要将数据改变一下形状,因为 RNN 读入的数据维度是 (
seq,batch,feature),所以要重新改变一下数据的维度,这里只有一个序列,所以batch是1,而输入的feature就是我们希望依据的几个月份,这里我们定的是两个月份,所以feature就是2.
import torch

train_X = train_X.reshape(-1, 1, 2)
train_Y = train_Y.reshape(-1, 1, 1)
test_X = test_X.reshape(-1, 1, 2)

train_x = torch.from_numpy(train_X)
train_y = torch.from_numpy(train_Y)
test_x = torch.from_numpy(test_X)
4 模型定义
模型的第一部分是一个两层的 RNN,每一步模型接受两个月的输入作为特征,得到一个输出特征。
接着通过一个线性层将 RNN 的输出回归到流量的具体数值
这里我们需要用view来重新排列,因为nn.Linear不接受三维的输入,所以我们先将前两维合并在一起,然后经过线性层之后再将其分开,最后输出结果。
from torch import nn
from torch.autograd import Variable

# 定义模型
class lstm_reg(nn.Module):
    def __init__(self, input_size, hidden_size, output_size=1, num_layers=2):
        # 输入是两个月的数据input_size=2,输出是下一个月的数据output_size=1,中间隐藏层的层数任意指定为4
        # input_size, hidden_size, output_size = 2,4,1

        super(lstm_reg, self).__init__()

#         self.rnn = nn.RNN(input_size,hidden_size,num_layers)  # RNN
#         self.rnn = nn.LSTM(input_size, hidden_size, num_layers)  # LSTM
        self.rnn = nn.GRU(input_size,hidden_size,num_layers)  # GRU

        self.reg = nn.Linear(hidden_size, output_size) # 回归

    def forward(self, x):
        x, _ = self.rnn(x) # (seq, batch, hidden)
        s, b, h = x.shape
        x = x.view(s*b, h) # 转换成线性层的输入格式
        x = self.reg(x)
        x = x.view(s, b, -1)
        return x
额外补充学习
OPT: 设置使用GPU,并将模型导入!(特别注意,数据和模型要同步,即都需要放到GPU上)
# 设置使用GPU
device = torch.device('cuda:0' if torch.cuda.is_available() else 'cpu')
# 使用定义好的RNN
model = rnn_model()
# 注意模型和输入数据都需要to device,训练数据后面传入
mode  = model.to(device)

...

# 数据送入GPU
var_x = train_x.to(device)
var_y = train_y.to(device)
net = lstm_reg(2, 4)

# tao(放到GPU上)
if torch.cuda.is_available():
    net = net.cuda()

criterion = nn.MSELoss()
optimizer = torch.optim.Adam(net.parameters(), lr=1e-2)
5 模型训练
定义好网络结构,输入的维度是 2,因为我们使用两个月的流量作为输入,隐藏层的维度可以任意指定,这里我们选的 4
模型训练一般包含几个步骤
取出数据及标签并均送入GPU或CPU
前向传播
计算损失函数
清空上一轮梯度
反向传播
参数更新
周期打印loss值或tensorboard数据保存绘图
保存模型参数(非必要)
# 开始训练

# 记录时间消耗 1/4
prev_time = datetime.datetime.now()  # time

for e in range(1000):

    # tao -> 数据送入GPU
    if torch.cuda.is_available():
        var_x = Variable(train_x).cuda()
        var_y = Variable(train_y).cuda()
    else:
        var_x = Variable(train_x)
        var_y = Variable(train_y)

#     var_x = Variable(train_x)
#     var_y = Variable(train_y)

    # 前向传播
    out = net(var_x)

    # 计算损失函数,传入的是预测值和真实值
    loss = criterion(out, var_y)

    # 反向传播
    # 反向传播之前先清空上一轮的梯度,在pytorch里边需要注意这个
    optimizer.zero_grad()
    # 反向传播
    loss.backward()

    # 参数更新
    optimizer.step()

    # 记录时间消耗 2/4
    cur_time = datetime.datetime.now()  # time
    hhh, remainder = divmod((cur_time - prev_time).seconds, 3600)  # time
    mmm, sss = divmod(remainder, 60)  # time
    time_str = "Time %02d:%02d:%02d" % (hhh, mmm, sss)  # time


    # 记录时间消耗 3/4
    prev_time = cur_time

    # loss值打印
    if (e + 1) % 100 == 0: # 每 100 次输出结果
        print('Epoch: {}, Loss: {:.5f}, Elapsed time:{}\n'.format(e + 1, loss.item(), cur_time))  # tao 修改: data[0] -> item()
#         print(cur_time) # 记录时间消耗 4/4
Output
### GPU.Elapsed time
Epoch: 100, Loss: 0.00025, Elapsed time:2021-04-11 17:21:05.236643
Epoch: 200, Loss: 0.00025, Elapsed time:2021-04-11 17:21:05.967594
Epoch: 300, Loss: 0.00024, Elapsed time:2021-04-11 17:21:06.717355
Epoch: 400, Loss: 0.00025, Elapsed time:2021-04-11 17:21:07.444206
Epoch: 500, Loss: 0.00022, Elapsed time:2021-04-11 17:21:08.175883
Epoch: 600, Loss: 0.00022, Elapsed time:2021-04-11 17:21:08.902753
Epoch: 700, Loss: 0.00022, Elapsed time:2021-04-11 17:21:09.635347
Epoch: 800, Loss: 0.00021, Elapsed time:2021-04-11 17:21:10.363685
Epoch: 900, Loss: 0.00023, Elapsed time:2021-04-11 17:21:11.115815
Epoch: 1000, Loss: 0.00020, Elapsed time:2021-04-11 17:21:11.855426

### CPU.Elapsed time
Epoch: 100, Loss: 0.00560, Elapsed time:2021-04-11 17:22:07.924255
Epoch: 200, Loss: 0.00378, Elapsed time:2021-04-11 17:22:10.740028
Epoch: 300, Loss: 0.00334, Elapsed time:2021-04-11 17:22:13.554055
Epoch: 400, Loss: 0.00344, Elapsed time:2021-04-11 17:22:16.364253
Epoch: 500, Loss: 0.00170, Elapsed time:2021-04-11 17:22:19.174960
Epoch: 600, Loss: 0.00148, Elapsed time:2021-04-11 17:22:21.981696
Epoch: 700, Loss: 0.00131, Elapsed time:2021-04-11 17:22:24.801310
Epoch: 800, Loss: 0.00147, Elapsed time:2021-04-11 17:22:27.607101
Epoch: 900, Loss: 0.00110, Elapsed time:2021-04-11 17:22:30.412770
Epoch: 1000, Loss: 0.00103, Elapsed time:2021-04-11 17:22:33.220409
6 预测结果
训练完成之后,我们可以用训练好的模型去预测后面的结果
# eval()会自动把BN和DropOut固定住,不会取平均,而是用训练好的值
net = net.eval() # 转换成测试模式
data_X = data_X.reshape(-1, 1, 2)
data_X = torch.from_numpy(data_X)
var_data = Variable(data_X)
pred_test = net(var_data.cuda()) # 测试集的预测结果 # tao ->  cuda()
# 改变输出的格式
pred_test = pred_test.view(-1).data.cpu().numpy() # tao -> .cpu()
# 画出实际结果和预测的结果
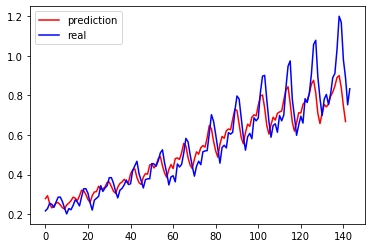
plt.plot(pred_test, 'r', label='prediction')
plt.plot(dataset, 'b', label='real')

# 添加图例,可以指定图例名,没有参数时默认上面的标签就是图例名
plt.legend(loc='best')
# plt.legend(['Prediction','Real'])
Output - LSTM@GPU
结果解读
蓝色的是真实的数据集,红色的是预测的结果;
我们能够看到,使用 lstm 能够得到比较相近的结果,预测的趋势也与真实的数据集是相同的,因为其能够记忆之前的信息,而单纯的使用线性回归并不能得到较好的结果,从这个例子也说明了 循环神经网络(
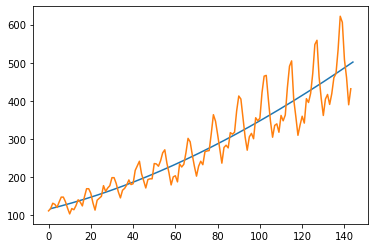
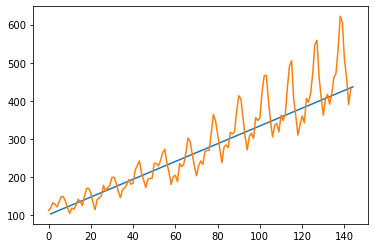
RNN) 对于序列有着非常好的性能。RNN模型比传统线性回归和多项式的非线性回归效果如何?下面给出结果代码和图!结果可以看出,RNN相较于对比的两种算法,优势十分明显,更能适应特征各异的数据!
Cmp01 传统线性回归模型
# 传统线性回归模型

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
#% matplotlib inline

# 加载数据
data_csv = pd.read_csv('./data.csv', usecols=[1])
#print(data.head())

data_csv = data_csv.dropna()
dataset = data_csv.values
dataset_ori = dataset.astype('float32')
# print(dataset_ori)


# 线性回归
from sklearn import linear_model
model = linear_model.LinearRegression()
y = dataset_ori
x = [[x] for x in range(1, len(y)+1)]

# print(x)
# print("---")
# print(y)

train_size = int(len(x) * 0.7)
train_x = x[:train_size]
train_y = y[:train_size]
model.fit(train_x, train_y)
y = model.predict(x)
# print(y)
plt.plot(x, y)
plt.plot(dataset_ori)
plt.show()
Output
Cmp02 多项式的非线性回归模型
# 多项式的非线性回归模型
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
#% matplotlib inline

# 加载数据
data_csv = pd.read_csv('./data.csv', usecols=[1])
#print(data.head())

data_csv = data_csv.dropna()
dataset = data_csv.values
dataset_ori = dataset.astype('float32')
# print(dataset_ori)


# 非线性回归
from sklearn.preprocessing import PolynomialFeatures
# 0-3次方
poly_reg = PolynomialFeatures(degree=3)
x_poly = poly_reg.fit_transform(x)
# print(x_poly)

train_x_poly = x_poly[:train_size]
model = linear_model.LinearRegression()
model.fit(train_x_poly, train_y)
y = model.predict(x_poly)

#print(len(x))
#print(len(y))

plt.plot(x, y)
plt.plot(dataset_ori)
plt.show()
Output