★
GANs的发展与改进
生成模型:自动编码器(
Autoencoder) 和 变分自动编码器(Variational AutoEncoder,VAE)生成对抗网络(
Generative Adversarial Networks,GANs):生成模型 vs. 对抗模型Improving GAN:
GAN的缺点以及改进的GAN(Wasserstein GAN, etc.)
前提1:MNIST数据集下载(附一种压缩&解压命令)
( ? ) 什么要压缩:文件夹在Jupyter notebook中无法直接下载(单个文件下载速度太慢且容易出错)
1.tar -cvf data_mnist.tar data  # 压缩 data 文件夹到 data_mnist.tar (目录相同)
2.tar -tf data_mnist.tar  # 查看压缩包内容
3.tar -xf data_mnist.tar -C  # 解压到当前目录
4.[or]
5.tar -xf data_mnist.tar -C ./anyfolder/  # 解压到当前目录的anyfolder文件夹下
前提2:GPU版PyTorch已安装
( ★ ) 查看方法:各种关于GPU信息的查看/设置命令
import os
import torch

print(torch.cuda.is_available())  # cuda是否可用; -> True
print(torch.cuda.device_count())  # 返回gpu数量;  -> 1
print(torch.cuda.get_device_name(0))  # 返回gpu名字,设备索引默认从0开始; -> GeForce GTX 1080 Ti
print(torch.cuda.current_device())  # 返回当前设备索引;  -> 0

# 如果device_count() 大于 1
# 可以指定GPU
os.environ['CUDA_VISIBLE_DEVICES']='0,1,2'  # 0, 1, 2
0 背景知识
生成模型(Generative Model)这一概念属于概率统计和机器学习, 是指一系列用于随机生成可观测数据的模型。
即:“生成”的样本和“真实”的样本尽可能地相似。
生成模型的两个主要功能:
学习一个概率分布
生成数据
知识回顾:
第一代卷积神经网络Lenet的时间是1998年,由Lecun提出;卷积神经网络(
CNN)适用于处理图像数据循环神经网络的提出时间是1986年,比卷积神经网络更早;循环神经网络(
RNN)适用于处理序列数据
CNN-> inception net、 resnet
RNN-> LSTM、GRU等不同的长短时记忆的网络(本质上,仍然是在
CNN和RNN的基础上作者监督学习的任务)希望机器能够完成创造性的工作(
AE,VAE的提出)
推进了整个无监督学习的发展进程(GANs的提出)
1 自动编码器(AE)
功能
① 最开始作为一种数据的压缩方法
② 在卷积网络中进行逐层预训练
③ 数据去噪
④ 可视化降维
⑤ 生成数据(☆)结构 & 工作
包括两个部分,第一部分是编码器(
encoder),第二部分是解码器(decoder);
编码器和解码器都可以是任意的模型,通常我们可以使用神经网络作为我们的编码器和解码器;输入的数据经过神经网络降维到一个编码,然后又通过另外一个神经网络解码得到一个与原始数据一模一样的生成数据,通过比较原始数据和生成数据,希望他们尽可能接近,所以最小化他们之间的差异来训练网络中编码器和解码器的参数;
当训练完成之后,
只需要拿出解码器的部分,然后随机传入code,就可以通过解码器生成各种各样的数据
使用 MNIST 数据集构建一个简单的自动编码器
import os

import torch
from torch.autograd import Variable
from torch import nn
from torch.utils.data import DataLoader

from torchvision.datasets import MNIST
from torchvision import transforms as tfs
from torchvision.utils import save_image

import matplotlib.pyplot as plt
import datetime
进行数据预处理和迭代器的构建
# transforms.Normalize()使得图片的大小变为-1~1之间,这是为了使输入变成一个比较对称的分布,训练更加容易收敛。
im_tfs = tfs.Compose([
    tfs.ToTensor(),
    tfs.Normalize([0.5], [0.5]) # 标准化      # 作者代码:tfs.Normalize([0.5, 0.5, 0.5], [0.5, 0.5, 0.5])
])

# 使用DataLoader生成一个读取图片的迭代器
train_set = MNIST('./data', transform=im_tfs)
train_data = DataLoader(train_set, batch_size=128, shuffle=True)
特别说明:这一步一般最好要有,个人经验来看,具有两个好处:
熟悉数据集;
验证数据读取是否成功!
print(train_set.data.size())

# 图片数据,打印一张出来看看
# 同时也是为了验证,数据读取是否成功!
plt.imshow(train_set.data[0].numpy(),cmap='gray')

plt.title('%i' % train_set.targets[0])              # 图片名称,显示真实标签,%i %d十进制整数,有区别,深入请查阅资料
plt.show()
定义网络(多层全连接神经网络 - 多层感知器)
特别注意★: 最后使用的激活函数是Tanh(),这个激活函数能够将最后的输出转换到-1~1之间,因为输入图片标准化在 -1 ~ 1 之间,所以输出也要在 -1 ~ 1 这个范围内
class autoencoder(nn.Module):
    def __init__(self):
        super(autoencoder, self).__init__()

        # 定义简单的多层全连接网络(4层网络)作为编码器,中间使用ReLU激活函数
        self.encoder = nn.Sequential(
            nn.Linear(28*28, 128),
            nn.ReLU(True),
            nn.Linear(128, 64),
            nn.ReLU(True),
            nn.Linear(64, 12),
            nn.ReLU(True),
            nn.Linear(12, 3) # 输出的 code 是 3 维,便于可视化
        )

        # 定义的解码器,输入 3 维的编码,输出一个28 x 28 的图像数据,特别注意★
        self.decoder = nn.Sequential(
            nn.Linear(3, 12),
            nn.ReLU(True),
            nn.Linear(12, 64),
            nn.ReLU(True),
            nn.Linear(64, 128),
            nn.ReLU(True),
            nn.Linear(128, 28*28),
            nn.Tanh()  # 特别注意★: 最后使用的激活函数是Tanh(),这个激活函数能够将最后的输出转换到-1~1之间
            # 因为输入图片标准化在 -1 ~ 1 之间,所以输出也要在 -1 ~ 1 这个范围内
        )

    def forward(self, x):
        encode = self.encoder(x)
        decode = self.decoder(encode)
        return encode, decode
net = autoencoder()

if torch.cuda.is_available():
    print("GPU Available")
    net = net.cuda()

x = Variable(torch.randn(1, 28*28)) # batch size 是 1

if torch.cuda.is_available():
    x = x.cuda()


code, _ = net(x)
print(code.shape)  # 可以看到最后得到的 code 就是三维的 -> torch.Size([1, 3])
criterion = nn.MSELoss(size_average=False)
optimizer = torch.optim.Adam(net.parameters(), lr=1e-3)
def to_img(x):
    '''
    定义一个函数将最后的结果转换回图片
    '''
    x = 0.5 * (x + 1.)
    x = x.clamp(0, 1)
    x = x.view(x.shape[0], 1, 28, 28)
    return x
训练网络
# 记录时间消耗 1/4
prev_time = datetime.datetime.now()  # time

# 开始训练自动编码器
temp = 1

for e in range(100):
    print(temp)
    temp = temp + 1

    for im, _ in train_data:

        im = im.view(im.shape[0], -1)
        im = Variable(im)

        if torch.cuda.is_available():
            im = im.cuda()

        # 前向传播
        _, output = net(im)
        loss = criterion(output, im) / im.shape[0] # 平均

        # 反向传播
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    # 记录时间消耗 2/4
    cur_time = datetime.datetime.now()  # time
    hhh, remainder = divmod((cur_time - prev_time).seconds, 3600)  # time
    mmm, sss = divmod(remainder, 60)  # time
    time_str = "Time %02d:%02d:%02d" % (hhh, mmm, sss)  # time

    # 记录时间消耗 3/4
    prev_time = cur_time

    if (e+1) % 20 == 0: # 每 20 次,将生成的图片保存一下
        print('epoch: {}, Loss: {:.4f}, Elapsed time:{}\n'.format(e + 1, loss.item(), cur_time)) # cur_time 记录时间消耗 4/4

        pic = to_img(output.cpu().data)

        if not os.path.exists('./simple_autoencoder'):
            os.mkdir('./simple_autoencoder')

        save_image(pic, './simple_autoencoder/image_{}.png'.format(e + 1))
输出结果
epoch: 20, Loss: 100.1256, Elapsed time:2021-04-14 10:24:30.591077
epoch: 40, Loss: 93.7939, Elapsed time:2021-04-14 10:28:11.433891
epoch: 60, Loss: 91.5714, Elapsed time:2021-04-14 10:31:51.640803
epoch: 80, Loss: 107.4346, Elapsed time:2021-04-14 10:35:32.260195
epoch: 100, Loss: 94.9293, Elapsed time:2021-04-14 10:39:12.342502
观测结果
训练完成之后查看生成的图片效果,可以发现,虽然图片具有较好的清晰度,但是轮廓有些模糊;
多层感知器能够做的比较有限,生成的图片还是比较模糊
import matplotlib.pyplot as plt
from matplotlib import cm
from mpl_toolkits.mplot3d import Axes3D
%matplotlib inline

# 可视化结果
view_data = Variable((train_set.train_data[:200].type(torch.FloatTensor).view(-1, 28*28) / 255. - 0.5) / 0.5)

if torch.cuda.is_available():
    view_data = view_data.cuda()

encode, _ = net(view_data)    # 提取压缩的特征值
fig = plt.figure(2)
ax = Axes3D(fig)    # 3D 图
# x, y, z 的数据值
X = encode.data[:, 0].cpu().numpy()
Y = encode.data[:, 1].cpu().numpy()
Z = encode.data[:, 2].cpu().numpy()
values = train_set.targets[:200].numpy()  # 标签值
for x, y, z, s in zip(X, Y, Z, values):
    c = cm.rainbow(int(255*s/9))    # 上色
    ax.text(x, y, z, s, backgroundcolor=c)  # 标位置
ax.set_xlim(X.min(), X.max())
ax.set_ylim(Y.min(), Y.max())
ax.set_zlim(Z.min(), Z.max())
plt.show()
输出结果
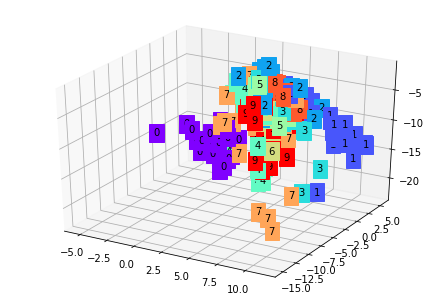
观测结果
不同种类的图片进入自动编码器之后会被编码得不同,
而相同类型的图片经过自动编码之后的编码在几何示意图上距离较近,
在训练好自动编码器之后,我们可以给一个随机的 code,通过 decoder 生成图片
code = Variable(torch.FloatTensor([[1.19, -3.36, 2.06]])) # 给一个 code 是 (1.19, -3.36, 2.06)
if torch.cuda.is_available():
    code = code.cuda()

decode = net.decoder(code)
decode_img = to_img(decode).squeeze()
decode_img = decode_img.data.cpu().numpy() * 255
plt.imshow(decode_img.astype('uint8'), cmap='gray') # 生成图片 3
输出结果
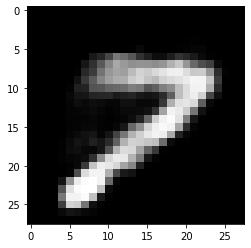
总结:以上仅仅使用多层神经网络定义了一个自动编码器;
接下来,使用卷积神经网络来重新定义一个卷积神经网络来进行 autoencoder
class conv_autoencoder(nn.Module):
    def __init__(self):
        super(conv_autoencoder, self).__init__()

        self.encoder = nn.Sequential(
            nn.Conv2d(1, 16, 3, stride=3, padding=1),  # (b, 16, 10, 10)
            nn.ReLU(True),
            nn.MaxPool2d(2, stride=2),  # (b, 16, 5, 5)
            nn.Conv2d(16, 8, 3, stride=2, padding=1),  # (b, 8, 3, 3)
            nn.ReLU(True),
            nn.MaxPool2d(2, stride=1)  # (b, 8, 2, 2)
        )

        self.decoder = nn.Sequential(
            nn.ConvTranspose2d(8, 16, 3, stride=2),  # (b, 16, 5, 5)
            nn.ReLU(True),
            nn.ConvTranspose2d(16, 8, 5, stride=3, padding=1),  # (b, 8, 15, 15)
            nn.ReLU(True),
            nn.ConvTranspose2d(8, 1, 2, stride=2, padding=1),  # (b, 1, 28, 28)
            nn.Tanh()
        )

    def forward(self, x):
        encode = self.encoder(x)
        decode = self.decoder(encode)
        return encode, decode
conv_net = conv_autoencoder()
if torch.cuda.is_available():
    conv_net = conv_net.cuda()
optimizer = torch.optim.Adam(conv_net.parameters(), lr=1e-3, weight_decay=1e-5)
解释:
这里的编码器使用了多层卷积神经网络;
解码器使用了转置卷积
torch.nn.ConvTranspose2d(),看作是卷积的反操作,可以在某种意义上看成是反卷积。
# 记录时间消耗 1/4
prev_time = datetime.datetime.now()  # time

# 开始训练自动编码器
temp = 1
for e in range(40):
    print(temp)
    temp = temp + 1
    for im, _ in train_data:

        if torch.cuda.is_available():
            im = im.cuda()
        im = Variable(im)
        # 前向传播
        _, output = conv_net(im)
        loss = criterion(output, im) / im.shape[0] # 平均
        # 反向传播
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()


    # 记录时间消耗 2/4
    cur_time = datetime.datetime.now()  # time
    hhh, remainder = divmod((cur_time - prev_time).seconds, 3600)  # time
    mmm, sss = divmod(remainder, 60)  # time
    time_str = "Time %02d:%02d:%02d" % (hhh, mmm, sss)  # time

    # 记录时间消耗 3/4
    prev_time = cur_time

    if (e+1) % 20 == 0: # 每 20 次,将生成的图片保存一下
        print('epoch: {}, Loss: {:.4f}, Elapsed time:{}\n'.format(e+1, loss.item(), cur_time)) # cur_time 记录时间消耗 4/4
        pic = to_img(output.cpu().data)
        if not os.path.exists('./conv_autoencoder'):
            os.mkdir('./conv_autoencoder')
        save_image(pic, './conv_autoencoder/image_{}.png'.format(e+1))
输出结果
epoch: 20, Loss: 113.5400, Elapsed time:2021-04-14 11:23:13.367150
epoch: 40, Loss: 94.0273, Elapsed time:2021-04-14 11:27:05.002844
AE的优缺点
优点:相比于随机取一个随机向量更好——自动编码器中需要输入一张图片,然后将一张图片编码之后得到一个隐含向量,这包含着原图片的信息,然后将隐含向量解码得到与原图片对应的照片;
缺点:不能生成任意图片——因为没办法自己取构造隐藏向量(因为我们并不知道 encode 之后的编码到底是什么样的概率分布),需要通过一张图片输入编码才知道得到的隐含向量是什么
解决这个缺点 -> 变法自动编码器
2 变分自动编码器(VAE)
原理
只需要在编码过程给它增加一些限制,迫使其生成的隐含向量能够粗略的遵循一个标准正态分布,这就是其与一般的自动编码器最大的不同。
优势:随机生成隐含变量;提高网络的泛化能力。
工作
这样就可以更加简单地生成一张新图片,即,只需要给它一个标准正态分布的随机隐含向量,这样通过解码器就能够生成想要的图片,而不需要给它一张原始图片先编码。
loss 1: 利用
KL divergence衡量encoder 得到的隐含向量的分布与一个标准的正态分布之间的相似程度;loss 2: 利用均方误差
MSE衡量生成图片与原图片之间的误差;说明
KL divergence是用来衡量两种分布相似程度的统计量,它越小,表示两种概率分布越接近。技巧“重新参数化”来解决
KL divergence的计算问题——避免计算KL divergence中的积分重新参数化——不再是每次生成一个隐含向量,而是生成两个向量:一个表示均值,一个表示标准差,然后通过着两个统计量
合成隐含向量(用一个标准正态分布先乘标准差再加上均值就行了,这里默认编码之后的隐含向量是服从一个正态分布的),最后 loss 就是希望这个生成的正态分布能够符合一个标准正态分布,也就是希望均值为 0,方差为 1
★ 变分自动编码器的实现(基于MNIST数据集)
import os

import torch
from torch.autograd import Variable
import torch.nn.functional as F
from torch import nn
from torch.utils.data import DataLoader

from torchvision.datasets import MNIST
from torchvision import transforms as tfs
from torchvision.utils import save_image
im_tfs = tfs.Compose([
    tfs.ToTensor(),
    tfs.Normalize([0.5], [0.5]) # 标准化 原作者代码:tfs.Normalize([0.5, 0.5, 0.5], [0.5, 0.5, 0.5])
])

train_set = MNIST('./data', transform=im_tfs)
train_data = DataLoader(train_set, batch_size=128, shuffle=True)
class VAE(nn.Module):
    def __init__(self):
        super(VAE, self).__init__()

        self.fc1 = nn.Linear(784, 400)
        self.fc21 = nn.Linear(400, 20) # mean
        self.fc22 = nn.Linear(400, 20) # var
        self.fc3 = nn.Linear(20, 400)
        self.fc4 = nn.Linear(400, 784)

    def encode(self, x):
        h1 = F.relu(self.fc1(x))
        return self.fc21(h1), self.fc22(h1)

    # 重新参数化
    def reparametrize(self, mu, logvar):
        std = logvar.mul(0.5).exp_()  # 参数 1 “标准差”
        eps = torch.FloatTensor(std.size()).normal_()  # 参数 2 “均值”
        if torch.cuda.is_available():
            eps = Variable(eps.cuda())
        else:
            eps = Variable(eps)
        return eps.mul(std).add_(mu)

    def decode(self, z):
        h3 = F.relu(self.fc3(z))
        return F.tanh(self.fc4(h3))

    def forward(self, x):
        mu, logvar = self.encode(x) # 编码
        z = self.reparametrize(mu, logvar) # 重新参数化成正态分布
        return self.decode(z), mu, logvar # 解码,同时输出均值方差
net = VAE() # 实例化网络
if torch.cuda.is_available():
    net = net.cuda()
x, _ = train_set[0]
x = x.view(x.shape[0], -1)
if torch.cuda.is_available():
    x = x.cuda()
x = Variable(x)
_, mu, var = net(x)
变量查看
print(mu)
变量查看 -> Output
tensor([[-0.2078, -0.0315, -0.3368,  0.2668, -0.1725, -0.0438, -0.0255, -0.2598,
          0.3098,  0.0805,  0.1474, -0.2702, -0.0527, -0.6565,  0.0457,  0.2047,
         -0.2575,  0.1529, -0.3746, -0.1734]], device='cuda:0',
       grad_fn=<AddmmBackward>)
可以看到,对于输入,网络可以输出隐含变量的均值和方差,这里的均值方差还没有训练
开始训练
reconstruction_function = nn.MSELoss(size_average=False)

def loss_function(recon_x, x, mu, logvar):
    """
    recon_x: generating images
    x: origin images
    mu: latent mean
    logvar: latent log variance
    """
    MSE = reconstruction_function(recon_x, x)
    # loss = 0.5 * sum(1 + log(sigma^2) - mu^2 - sigma^2)
    KLD_element = mu.pow(2).add_(logvar.exp()).mul_(-1).add_(1).add_(logvar)
    KLD = torch.sum(KLD_element).mul_(-0.5)
    # KL divergence
    return MSE + KLD

optimizer = torch.optim.Adam(net.parameters(), lr=1e-3)
def to_img(x):
    '''
    定义一个函数将最后的结果转换回图片
    '''
    x = 0.5 * (x + 1.)
    x = x.clamp(0, 1)
    x = x.view(x.shape[0], 1, 28, 28)
    return x
for e in range(100):
    for im, _ in train_data:
        im = im.view(im.shape[0], -1)
        im = Variable(im)
        if torch.cuda.is_available():
            im = im.cuda()
        recon_im, mu, logvar = net(im)
        loss = loss_function(recon_im, im, mu, logvar) / im.shape[0] # 将 loss 平均
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    if (e + 1) % 20 == 0:
        print('epoch: {}, Loss: {:.4f}'.format(e + 1, loss.item()))
        save = to_img(recon_im.cpu().data)
        if not os.path.exists('./vae_img'):
            os.mkdir('./vae_img')
        save_image(save, './vae_img/image_{}.png'.format(e + 1))
输出结果
epoch: 20, Loss: 64.6217
epoch: 40, Loss: 63.8465
epoch: 60, Loss: 64.0109
epoch: 80, Loss: 66.6021
epoch: 100, Loss: 60.1428
结论
使用变分自动编码器得到的结果,可以发现效果比一般的编码器要好很多
查看均值
x, _ = train_set[0]
x = x.view(x.shape[0], -1)
if torch.cuda.is_available():
    x = x.cuda()
x = Variable(x)
_, mu, _ = net(x)
print(mu)
变量查看 -> Output
tensor([[-1.7890, -1.4560,  2.4941, -1.5575,  0.6719, -0.4668, -0.0496, -0.5515,
         -0.2201,  0.7045, -0.6811, -0.3978,  1.3749,  0.0168,  0.6829, -0.7402,
         -0.6127, -0.7239,  2.8570, -0.9265]], device='cuda:0',
       grad_fn=<AddmmBackward>)
VAE的优缺点
优点:比一般的自动编码器效果要好,而且也限制了其输出的编码 (code) 的概率分布;
缺点:
仍然是通过直接计算生成图片和原始图片的均方误差来生成 loss,生成的图片依然会有点模糊
即:针对loss定义方法
不论是自动编码器还是变分自动编码器,都是通过计算生成图像和输入图像在每个像素点的误差来生成 loss,这一点是特别不好的,因为不同的像素点可能造成不同的视觉结果,但是可能他们的 loss 是相同的,所以通过单个像素点来得到 loss 是不准确的,这个时候我们需要一种全新的 loss 定义方式,就是通过对抗进行学习。
解决这个缺点 -> 生成对抗网络 : 一种新的训练办法——通过生成对抗的训练方式来训练网络而不是直接比较两张图片的每个像素点的均方误差
3 生成对抗网络(GANs)
组成
生成模型:类似自动编码器的解码部分
对抗模型:判断真假图片的判别器
工作
让两个网络相互竞争,通过生成网络来生成假的数据,对抗网络通过判别器判别真伪,最后希望生成器生成的数据能够以假乱真骗过判别器。
介绍
生成模型:
一般的生成模型——自动编码器
随机初始化一个隐含向量,根据变分自动编码的特点,初始化一个正态分布的隐含向量,通过类似解码的过程,将它映射到一个更高的维度,
最后生成一个与输入数据相似的数据,这就是假的图片。【生成对抗网络会通过对抗过程来计算出这个损失函数】
对抗模型:
对抗过程可简化为一个判断真假的判别器,相当于一个二分类问题,即
输入一张真的图片希望判别器输出的结果是1;
输入一张假的图片希望判别器输出的结果是0。这跟原图片的label没有关系,即,不管原图片到底是一个多少类别的图片,它们都统一称为真的图片,输出的label是1;对于生成的假的图片,其label是0。
训练
在训练的时候,先训练判别器,将假的数据和真的数据都输入给判别模型,这个时候优化这个判别模型;希望它能够正确地判断出真的数据和假的数据,这样就能够得到一个比较好的判别器。
然后开始训练生成器, 希望它生成的假的数据能够骗过现在这个比较好的判别器。
具体做法:将判别器的参数固定,通过反向传播优化生成器的参数,希望生成器得到的数据在经过判别器之后得到的结果能尽可能地接近1,这时只需要调整一下损失函数即可(!)。之前在优化判别器的时候损失函数是让假的数据尽可能接近0,而现在训练生成器的损失函数是让假的数据尽可能接近1。
我们训练的过程就是希望这个判别器能够正确的判出真的图片和假的图片,这其实就是一个简单的二分类问题,对于这个问题可以用我们前面讲过的很多方法去处理,比如
logistic 回归,深层网络(多层感知器),卷积神经网络(CNN),循环神经网络(RNN)都可以。Improving GAN
关于生成对抗网络,出现了很多变形,比如
LS-GAN,WGAN等等
3.1 简单版本的生成对抗网络
一个简单版本的网络结构,生成网络和对抗网络都是简单的多层神经网络
通过前面我们知道生成对抗网络有两个部分构成,一个是生成网络,一个是对抗网络,我们首先写一个简单版本的网络结构,生成网络和对抗网络都是简单的多层神经网络
import torch
from torch import nn
from torch.autograd import Variable

import torchvision.transforms as tfs
from torch.utils.data import DataLoader, sampler
from torchvision.datasets import MNIST

import numpy as np

import matplotlib.pyplot as plt
import matplotlib.gridspec as gridspec

%matplotlib inline
plt.rcParams['figure.figsize'] = (10.0, 8.0) # 设置画图的尺寸
plt.rcParams['image.interpolation'] = 'nearest'
plt.rcParams['image.cmap'] = 'gray'

def show_images(images): # 定义画图工具
    images = np.reshape(images, [images.shape[0], -1])
    sqrtn = int(np.ceil(np.sqrt(images.shape[0])))
    sqrtimg = int(np.ceil(np.sqrt(images.shape[1])))

    fig = plt.figure(figsize=(sqrtn, sqrtn))
    gs = gridspec.GridSpec(sqrtn, sqrtn)
    gs.update(wspace=0.05, hspace=0.05)

    for i, img in enumerate(images):
        ax = plt.subplot(gs[i])
        plt.axis('off')
        ax.set_xticklabels([])
        ax.set_yticklabels([])
        ax.set_aspect('equal')
        plt.imshow(img.reshape([sqrtimg,sqrtimg]))
    return

def preprocess_img(x):
    x = tfs.ToTensor()(x)
    return (x - 0.5) / 0.5

def deprocess_img(x):
    return (x + 1.0) / 2.0
class ChunkSampler(sampler.Sampler): # 定义一个取样的函数
    """Samples elements sequentially from some offset.
    Arguments:
        num_samples: # of desired datapoints
        start: offset where we should start selecting from
    """
    def __init__(self, num_samples, start=0):
        self.num_samples = num_samples
        self.start = start

    def __iter__(self):
        return iter(range(self.start, self.start + self.num_samples))

    def __len__(self):
        return self.num_samples

NUM_TRAIN = 50000
NUM_VAL = 5000

NOISE_DIM = 96
batch_size = 128

train_set = MNIST('./data', train=True, download=True, transform=preprocess_img)

train_data = DataLoader(train_set, batch_size=batch_size, sampler=ChunkSampler(NUM_TRAIN, 0))

val_set = MNIST('./data', train=True, download=True, transform=preprocess_img)

val_data = DataLoader(val_set, batch_size=batch_size, sampler=ChunkSampler(NUM_VAL, NUM_TRAIN))


imgs = deprocess_img(train_data.__iter__().next()[0].view(batch_size, 784)).numpy().squeeze() # 可视化图片效果
show_images(imgs)
Output
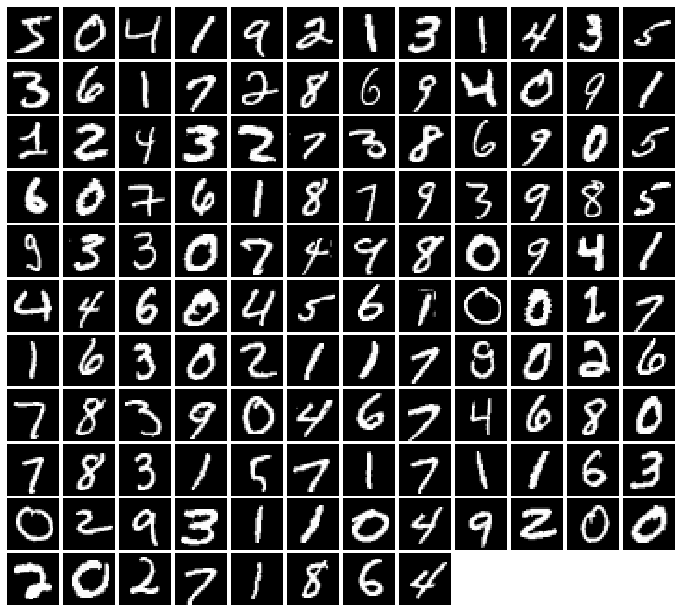
判别网络
判别网络的结构非常简单,就是一个二分类器
def discriminator():
    net = nn.Sequential(
            nn.Linear(784, 256),
            nn.LeakyReLU(0.2),  # 这里使用了斜率为0.2的LeakyReLU激活函数,不用ReLU的原因是,经过实验发现,LeakyReLU的表现更好
            nn.Linear(256, 256),
            nn.LeakyReLU(0.2),
            nn.Linear(256, 1)
            # sigmoid? 书上提出这里用了Sigmoid()激活函数,但是实际的代码中,没有使用?
        )
    return net
生成网络
生成网络的结构是根据一个随机噪声生成一个和数据维度一样的张量
def generator(noise_dim=NOISE_DIM):
    net = nn.Sequential(
        nn.Linear(noise_dim, 1024),
        nn.ReLU(True),
        nn.Linear(1024, 1024),
        nn.ReLU(True),
        nn.Linear(1024, 784),
        nn.Tanh()  # 最后需要使用nn.Tanh(),将数据分布到-1~1之间,这是因为输入的图片会规范化到-1~1之间。
    )
    return net
定义生成对抗网络的 loss
# 对于对抗网络,相当于二分类问题,将真的判别为真的,假的判别为假的
bce_loss = nn.BCEWithLogitsLoss()  # Binary Cross Entropy 二分类的损失函数

def discriminator_loss(logits_real, logits_fake): # 判别器的 loss
    size = logits_real.shape[0]
    true_labels = Variable(torch.ones(size, 1)).float().cuda()
    false_labels = Variable(torch.zeros(size, 1)).float().cuda()
    loss = bce_loss(logits_real, true_labels) + bce_loss(logits_fake, false_labels)
    return loss
def generator_loss(logits_fake): # 生成器的 loss
    size = logits_fake.shape[0]
    true_labels = Variable(torch.ones(size, 1)).float().cuda()
    loss = bce_loss(logits_fake, true_labels)
    return loss
# 使用 adam 来进行训练,学习率是 3e-4, beta1 是 0.5, beta2 是 0.999
def get_optimizer(net):
    optimizer = torch.optim.Adam(net.parameters(), lr=3e-4, betas=(0.5, 0.999))
    return optimizer
开始训练
# 【先】训练判别器
# 【后】训练生成器
def train_a_gan(D_net, G_net, D_optimizer, G_optimizer, discriminator_loss, generator_loss, show_every=250,
                noise_size=96, num_epochs=10):
    iter_count = 0
    for epoch in range(num_epochs):
        for x, _ in train_data:
            bs = x.shape[0]
            # 判别网络
            real_data = Variable(x).view(bs, -1).cuda() # 真实数据
            logits_real = D_net(real_data) # 判别网络得分

            sample_noise = (torch.rand(bs, noise_size) - 0.5) / 0.5 # -1 ~ 1 的均匀分布
            g_fake_seed = Variable(sample_noise).cuda()
            fake_images = G_net(g_fake_seed) # 生成的假的数据
            logits_fake = D_net(fake_images) # 判别网络得分

            d_total_error = discriminator_loss(logits_real, logits_fake) # 判别器的 loss
            D_optimizer.zero_grad()
            d_total_error.backward()
            D_optimizer.step() # 优化判别网络

            # 生成网络
            g_fake_seed = Variable(sample_noise).cuda()
            fake_images = G_net(g_fake_seed) # 生成的假的数据

            gen_logits_fake = D_net(fake_images)
            g_error = generator_loss(gen_logits_fake) # 生成网络的 loss
            G_optimizer.zero_grad()
            g_error.backward()
            G_optimizer.step() # 优化生成网络

            if (iter_count % show_every == 0):
                print('Iter: {}, D: {:.4}, G:{:.4}'.format(iter_count, d_total_error.item(), g_error.item()))  # tao
                imgs_numpy = deprocess_img(fake_images.data.cpu().numpy())
                show_images(imgs_numpy[0:16])
                plt.show()
                print()
            iter_count += 1
D = discriminator().cuda()
G = generator().cuda()

D_optim = get_optimizer(D)
G_optim = get_optimizer(G)

train_a_gan(D, G, D_optim, G_optim, discriminator_loss, generator_loss)
总结
上述使用简单的多层全连接神经网络实现了一个简单的生成对抗网络(最基本的生成对抗网络),【但是可以看到效果并不是特别好,生成的数字也不是特别完整】
其他变式(结构orloss)
Least Squares GAN(loss上的变式):使用了最小平方误差(均方误差最小化、最小二乘法)来进行评估,而不是二分类的损失函数,比最原始的GANs的loss更加稳定。
3.2 Least Squares GAN
def ls_discriminator_loss(scores_real, scores_fake):
    loss = 0.5 * ((scores_real - 1) ** 2).mean() + 0.5 * (scores_fake ** 2).mean()
    return loss

def ls_generator_loss(scores_fake):
    loss = 0.5 * ((scores_fake - 1) ** 2).mean()
    return loss
D = discriminator().cuda()
G = generator().cuda()

D_optim = get_optimizer(D)
G_optim = get_optimizer(G)

train_a_gan(D, G, D_optim, G_optim, ls_discriminator_loss, ls_generator_loss)
上面是最基本的 GAN 和 least squares GAN,下面是使用卷积网络的GAN,叫做深度卷积生成对抗网络(Deep Convolutional GANs, DC GAN)
3.3 Deep Convolutional GANs
深度卷积生成对抗网络就是将生成网络和对抗网络都改成了卷积网络的形式
生成对抗网络的训练比较困难,因为这是两个对偶网络在相互学习,所以需要增加一些训练技巧才能使训练更加稳定:
比如在卷积神经网络里引入批标准化(Batch Normalization)来稳定训练,同时使用LeakyReLU和平均池化来进行训练。
对于生成对抗网络而言,它其实并没有真正地学习到它要表示的物体,通过对抗的过程,它只是生成了一张尽可能真的图片,这就意味着没办法决定用哪种噪声能够生成想要的图片,除非把初始分布都试一遍
GAN的本质:通过改变训练的过程来避免烦琐的计算
引出 -> 基于标准生成对抗网络的变式(用于解决各种各样的问题)
卷积判别网络
卷积判别网络就是一个一般的卷积网络,结构如下
32 Filters, 5x5, Stride 1, Leaky ReLU(alpha=0.01)
Max Pool 2x2, Stride 2
64 Filters, 5x5, Stride 1, Leaky ReLU(alpha=0.01)
Max Pool 2x2, Stride 2
Fully Connected size 4 x 4 x 64, Leaky ReLU(alpha=0.01)
Fully Connected size 1
class build_dc_classifier(nn.Module):
    def __init__(self):
        super(build_dc_classifier, self).__init__()
        self.conv = nn.Sequential(
            nn.Conv2d(1, 32, 5, 1),
            nn.LeakyReLU(0.01),
            nn.MaxPool2d(2, 2),
            nn.Conv2d(32, 64, 5, 1),
            nn.LeakyReLU(0.01),
            nn.MaxPool2d(2, 2)
        )
        self.fc = nn.Sequential(
            nn.Linear(1024, 1024),
            nn.LeakyReLU(0.01),
            nn.Linear(1024, 1)
        )

    def forward(self, x):
        x = self.conv(x)
        x = x.view(x.shape[0], -1)
        x = self.fc(x)
        return x
卷积生成网络
卷积生成网络需要将一个低维的噪声向量变成一个图片数据,结构如下
Fully connected of size 1024, ReLU
BatchNorm
Fully connected of size 7 x 7 x 128, ReLU
BatchNorm
Reshape into Image Tensor
64 conv2d^T filters of 4x4, stride 2, padding 1, ReLU
BatchNorm
1 conv2d^T filter of 4x4, stride 2, padding 1, TanH
class build_dc_generator(nn.Module):
    def __init__(self, noise_dim=NOISE_DIM):
        super(build_dc_generator, self).__init__()
        self.fc = nn.Sequential(
            nn.Linear(noise_dim, 1024),
            nn.ReLU(True),
            nn.BatchNorm1d(1024),  # 引入了批标准化(Batch Normalization)来稳定训练
            nn.Linear(1024, 7 * 7 * 128),
            nn.ReLU(True),
            nn.BatchNorm1d(7 * 7 * 128)
        )

        self.conv = nn.Sequential(
            nn.ConvTranspose2d(128, 64, 4, 2, padding=1),
            nn.ReLU(True),
            nn.BatchNorm2d(64),
            nn.ConvTranspose2d(64, 1, 4, 2, padding=1),
            nn.Tanh()
        )

    def forward(self, x):
        x = self.fc(x)
        x = x.view(x.shape[0], 128, 7, 7) # reshape 通道是 128,大小是 7x7
        x = self.conv(x)
        return x
def train_dc_gan(D_net, G_net, D_optimizer, G_optimizer, discriminator_loss, generator_loss, show_every=250,
                noise_size=96, num_epochs=10):
    iter_count = 0
    for epoch in range(num_epochs):
        for x, _ in train_data:
            bs = x.shape[0]
            # 判别网络
            real_data = Variable(x).cuda() # 真实数据
            logits_real = D_net(real_data) # 判别网络得分

            sample_noise = (torch.rand(bs, noise_size) - 0.5) / 0.5 # -1 ~ 1 的均匀分布
            g_fake_seed = Variable(sample_noise).cuda()
            fake_images = G_net(g_fake_seed) # 生成的假的数据
            logits_fake = D_net(fake_images) # 判别网络得分

            d_total_error = discriminator_loss(logits_real, logits_fake) # 判别器的 loss
            D_optimizer.zero_grad()
            d_total_error.backward()
            D_optimizer.step() # 优化判别网络

            # 生成网络
            g_fake_seed = Variable(sample_noise).cuda()
            fake_images = G_net(g_fake_seed) # 生成的假的数据

            gen_logits_fake = D_net(fake_images)
            g_error = generator_loss(gen_logits_fake) # 生成网络的 loss
            G_optimizer.zero_grad()
            g_error.backward()
            G_optimizer.step() # 优化生成网络

            if (iter_count % show_every == 0):
                print('Iter: {}, D: {:.4}, G:{:.4}'.format(iter_count, d_total_error.item(), g_error.item()))
                imgs_numpy = deprocess_img(fake_images.data.cpu().numpy())
                show_images(imgs_numpy[0:16])
                plt.show()
                print()
            iter_count += 1
D_DC = build_dc_classifier().cuda()
G_DC = build_dc_generator().cuda()

D_DC_optim = get_optimizer(D_DC)
G_DC_optim = get_optimizer(G_DC)

train_dc_gan(D_DC, G_DC, D_DC_optim, G_DC_optim, discriminator_loss, generator_loss, num_epochs=5)
★ 可以看到,通过 DC GANs 能够得到更加清楚的结果
3.4 Improving GAN
局限
① GAN的训练非常麻烦,需要很多训练技巧
② 在不同的数据集上,由于数据的分布会发生变化,也需要重新调整参数
③ 需要小心地平衡生成器和判别器的训练过程
④ 生成的样本还缺乏多样性
⑤ 最大的问题:没办法衡量这个生成器到底好不好,因为没办法通过判别器的loss去判断这个事情。(虽然DC GAN依靠对生成器和判别器的结构进行枚举,最终找到了一个比较好的网络设置,但还是没有从根本上解决训练的问题。)
Wasserstein GAN
WGAN彻底解决的难点
① 彻底解决了训练不稳定的问题,不再需要设计参数去平衡判别器和生成器
② 基本解决了collapse mode的问题,确保了生成样本的多样性
③ 训练中有一个向交叉熵、准确率的数值指标来衡量训练的进程,数值越小代表GAN训练得越好,同时也就代表着生成的图片质量越高
④ 不需要精心设计网络结构,用简单的多层感知器就能够取得比较好的效果
发展(
衡量真实分布与生成分布之间的差异)
发展线:KL Divergence -> JS Divergence -> Wasserstein距离
KL Divergence是不对称的;
↓JS Divergence是对称的;但有一个严重的问题,那就是如果两种分布完全没有重叠部分,或者说重叠部分可忽略,那么JS Divergence将恒等于log2, log2 -> 0是突变的;
↓新的度量方式:Wasserstein距离(也称为Earth Mover距离–推土机距离),不管两种分布是否有重叠,它都是连续变换的,不是突变的。但是W距离有一个无法求解的问题。
↓引入新的概念——Lipschitz连续。构造一个神经网络D作为判别器,使得满足Lipschitz条件的函数变化能比较平缓。满足Lipschitz连续条件,需要做权重裁剪。
↓
(
Improving WGAN)
总结
原始的GAN做的是二分类的任务,也就是对于真假图片进行二分类,而WGAN做的是回归问题,相当于近似拟合Wasserstein距离。
WGAN与原始的GAN相比,只改了以下4点:
① 判别器最后一层去掉sigmoid
② 生成器和判别器的loss不取log
③ 每次更新判别器的参数之后把它们的绝对值
裁剪到不超过一个固定常数的数④ 不再用基于动量的优化算法(比如momentuem 和 Adam),推荐使用RMSProp
①-③:理论分析得到;④作者实验发现。
对比
第一:WGAN如果使用类似DC GAN的结构,那么和DC GAN生成的图片差不多;但是WGAN的优势就在于不用DC GAN的结构,也能生成效果比较好的图片,但是把DC GAN的Batch Normalization拿掉的话,DC GAN就不能生成图片了;
第二:WGAN和原始的GAN都是用多层全连接网络的话,WGAN生成的图片质量会变得差一些,但是原始的GAN不仅质量很差,还有多样性不足的问题。
Improving WGAN
WGAN在满足一阶Lipschitz连续性条件,在训练的时候加了限制——权重裁剪
除了权重裁剪外,还可以有其他方法
引入定理(
一个可微函数如果满足1阶Lipschitz连续,等价于它的梯度范数处小于1),这样不需要在整个分布上都满足Lipschitz条件,只需要沿着一些直线上的点满足这些,结果即可变得很好。(Improving WGAN 相比 WGAN训练更加稳定,生成的图片效果也更好。)